Как Anthropic масштабировала CI: анализ влияния тестов в эпоху агентного программирования
За шесть месяцев объём задач в CI у Anthropic вырос в 25 раз. Пока команда искала устойчивое решение, сервис выбора тестов пришлось экстренно чинить трижды — и одно из этих «решений» прожило меньше суток.
ИИ меняет пределы CI
В среднем инженеры Anthropic за квартал выпускают в восемь раз больше кода, чем в период 2021–2025 годов. Около 80% этого кода создаёт Claude; он же участвует в проверке и согласовании запросов на слияние (pull request). Когда написание и ревью кода перестают быть узким местом, давление почти неизбежно смещается в CI. Туда, где раньше было сравнительно тихо.
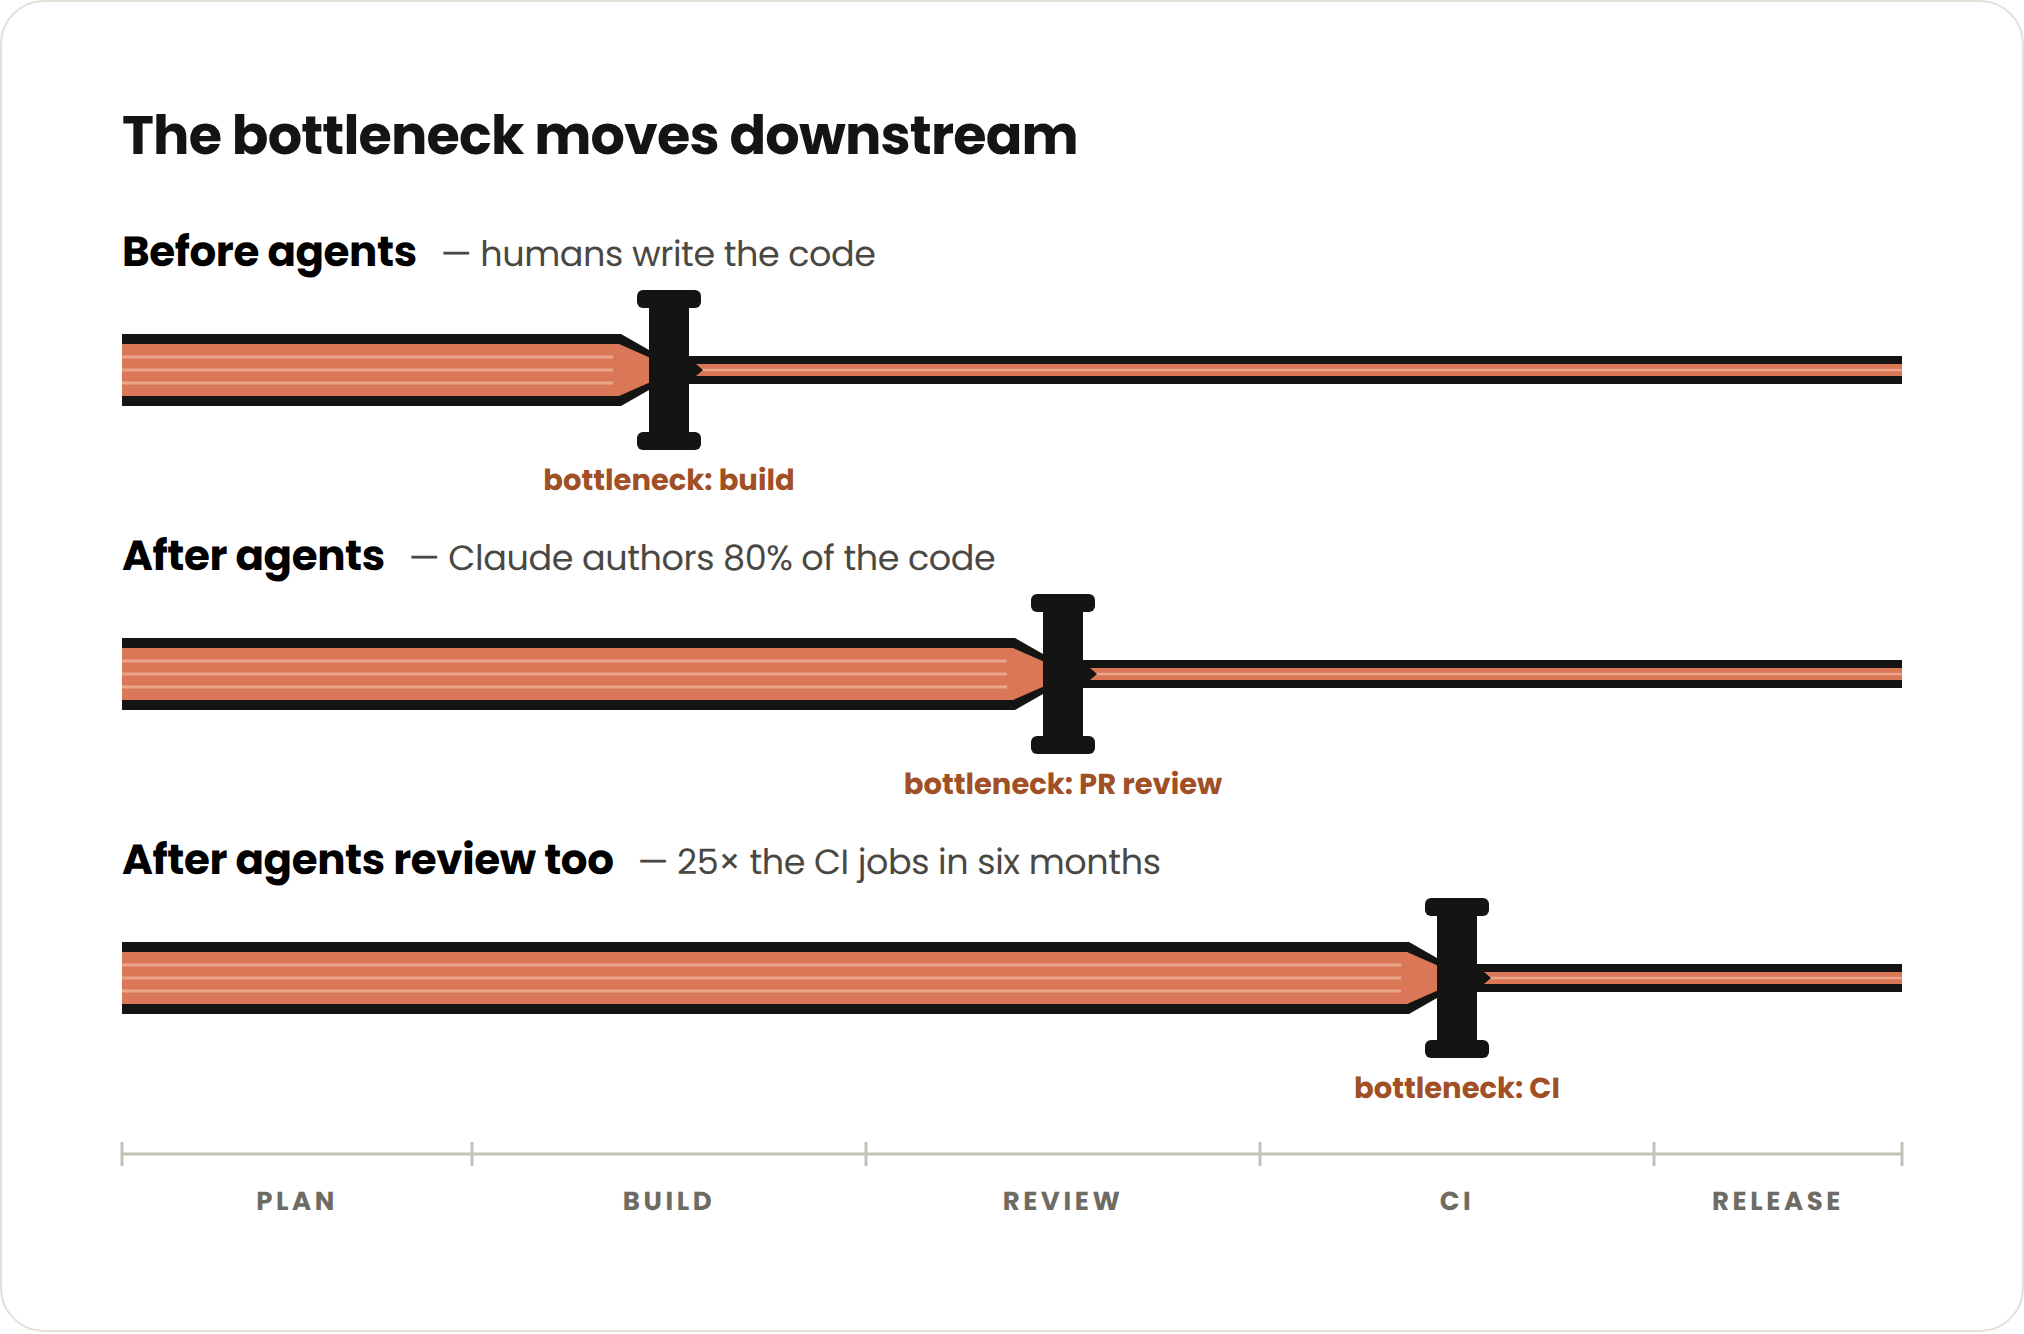
За тот же период количество тестов в кодовой базе увеличилось примерно в десять раз, а численность инженерной команды — совсем ненамного. Итог: за полгода число CI-задач выросло в 25 раз. Цифра выглядит странно лишь до тех пор, пока не вспомнишь: не каждый тест запускается для каждого PR.
Этот рост несколько раз едва не положил сервис анализа влияния тестов. Команде пришлось пересмотреть и реализацию, и саму архитектурную логику системы. Сначала были быстрые заплатки: одна продержалась 70 дней, другая — 29, третья — меньше дня. Знакомая инфраструктурная математика: временное решение всегда хочет задержаться, но нагрузка обычно думает иначе.
Для команд, которые планируют внедрение ИИ в процессы разработки, это уже не экзотический сценарий. Агентные инструменты генерируют больше изменений, создают больше небольших PR и требуют быстрого цикла обратной связи. Значит, CI должен расти не линейно, а с запасом — и довольно дерзким.
Как работает анализ влияния тестов
Некоторые организации всё ещё запускают весь набор тестов на каждое изменение. На небольшом проекте это терпимо. В крупной кодовой базе такой подход быстро превращает CI в дорогую и медленную очередь: гейты удлиняются, счета растут, а надёжность не становится лучше.
Кроме того, человеку обычно несложно понять, что падение теста не связано с его изменением. Агенту для такого вывода нужны данные и контекст. Если дать ему точный набор релевантных тестов, он сможет самостоятельно проверять результат, исправлять ошибки и делать следующую итерацию заметно быстрее.
В Anthropic использовали детерминированный сервис анализа влияния тестов — по сути, систему выбора тестов. Она определяет, какие проверки запускать для конкретного изменения, опираясь на историю тестов и связь изменений с пакетами. Похожий подход лежит в основе контекстной инженерии для AI-агентов: решение должно получать именно тот контекст, который нужен для действия, а не тонуть в лишнем шуме.
Сервис состоял из двух синхронно работающих компонентов:
- Слушатель записывал результаты тестов после каждого запуска CI.
- Селектор читал историю результатов и выбирал тесты для открытых PR.
Поначалу схема была эффективной. Но при большом потоке задач слушатель стал отставать от очереди PR. В жизненном цикле разработки с ИИ даже двадцатиминутное отставание — не мелочь: за это время в селектор могут не попасть десятки тысяч обновлений результатов.
- Неудачное изменение уже смержено. Тест начинает падать у всех, а инженеры тратят время на бессмысленные расследования.
- Зависимость стала нестабильной. Флак-тесты начинают блокировать слияние изменений.
- Тест исправили или добавили. Пока слушатель не догонит очередь, нужная проверка может вообще не запускаться — а это уже риск регрессии.
Первоначальная версия работала как единый процесс: для ведения истории каждого теста использовался один процесс записи. Такой дизайн с единственным экземпляром не позволял нормально шардировать нагрузку по горизонтали.
Три быстрых исправления
Исправление №1: машина помощнее
К октябрю сервис явно начал задыхаться, а команду два дня подряд вызывали по пейджеру. Первое решение было очевидным: удвоить число ядер у машины, на которой работал сервис. Это помогло — ненадолго. Все понимали, что запас времени куплен, а не проблема решена.
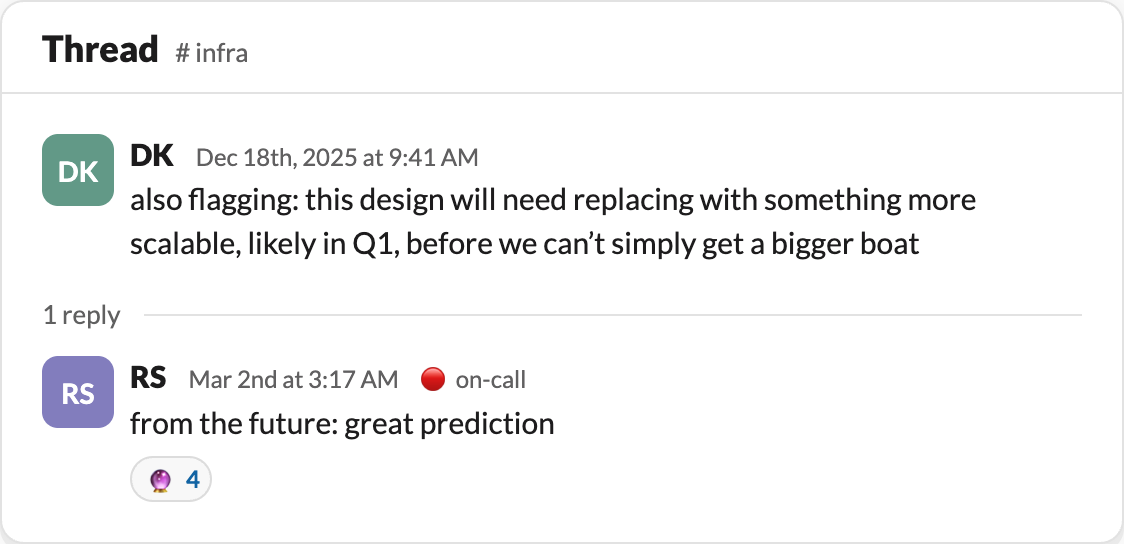
Хотя тренд был виден невооружённым глазом, владельца проблемы долго не находилось. Никому не хотелось брать ещё один инфраструктурный сервис, а у CI-команды имелись задачи с более высоким приоритетом. Обычная история, без злодеев.
Исправление №2: шардирование
Пейджеры продолжали звенеть: отставание слушателя росло. Чтобы не терять контекст между обсуждениями, автор завёл долгую сессию во внутренней версии Claude Tag, посвящённую наблюдению за сервисом. Когда бэклог превышал 50 000 задач, Claude отправлял уведомление и возвращал разговор к вопросу о следующем шаге.
Месяцами система напоминала команде о предыдущих попытках, гипотезах и компромиссах. Claude нередко предлагал полноценный редизайн, но команда снова и снова выбирала очередной патч. Это не иррационально: у срочных задач всегда очень убедительный голос.
В феврале рост CI-задач снова стал проблемой. Команда решила распараллелить обработку. Выяснилось, что единый процесс записи нужен не для всей истории тестов, а только для корректного порядка результатов внутри конкретного пакета. Claude помог сгенерировать код, который разделил состояние пакетов на шарды с отдельными воркер-процессами.
Патч был полезным, но его хватило всего на 29 дней.
Исправление №3: ежедневный перезапуск
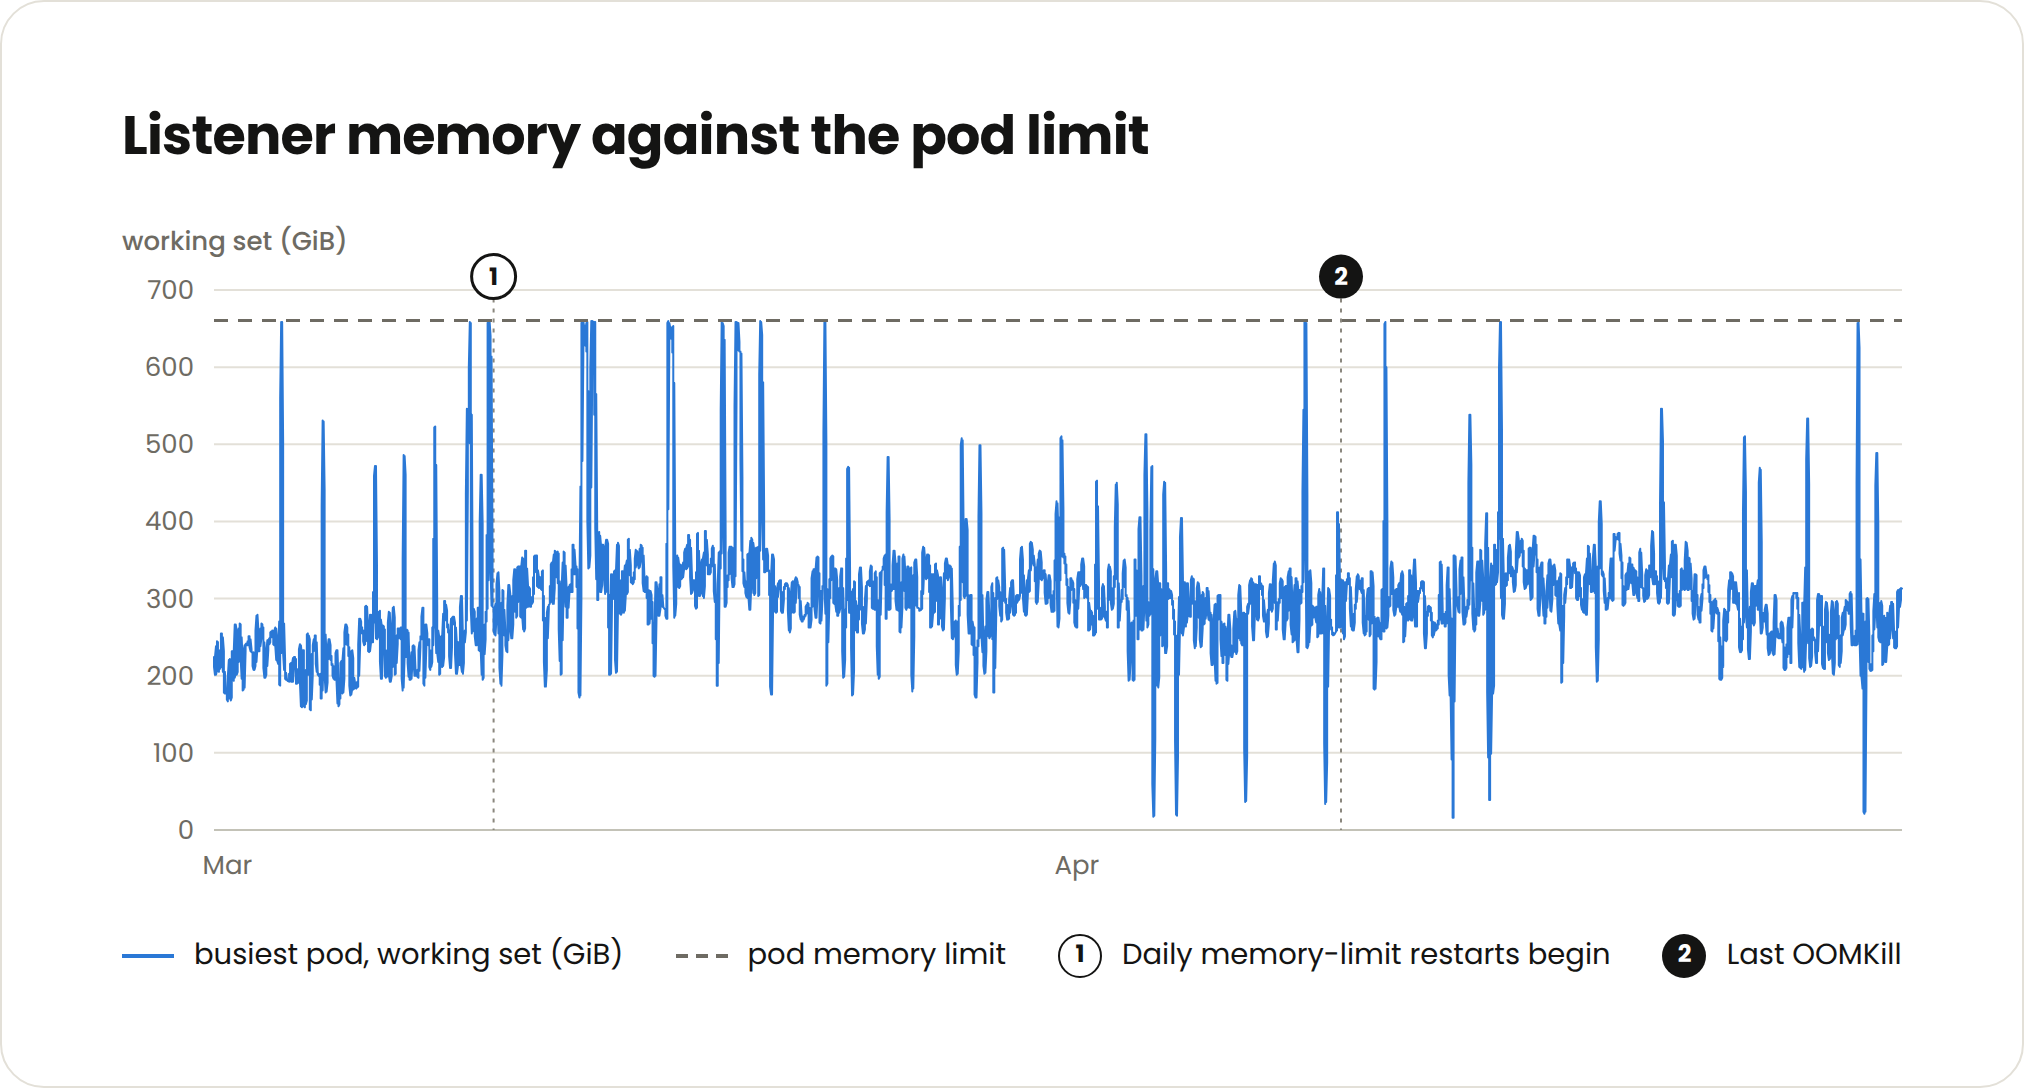
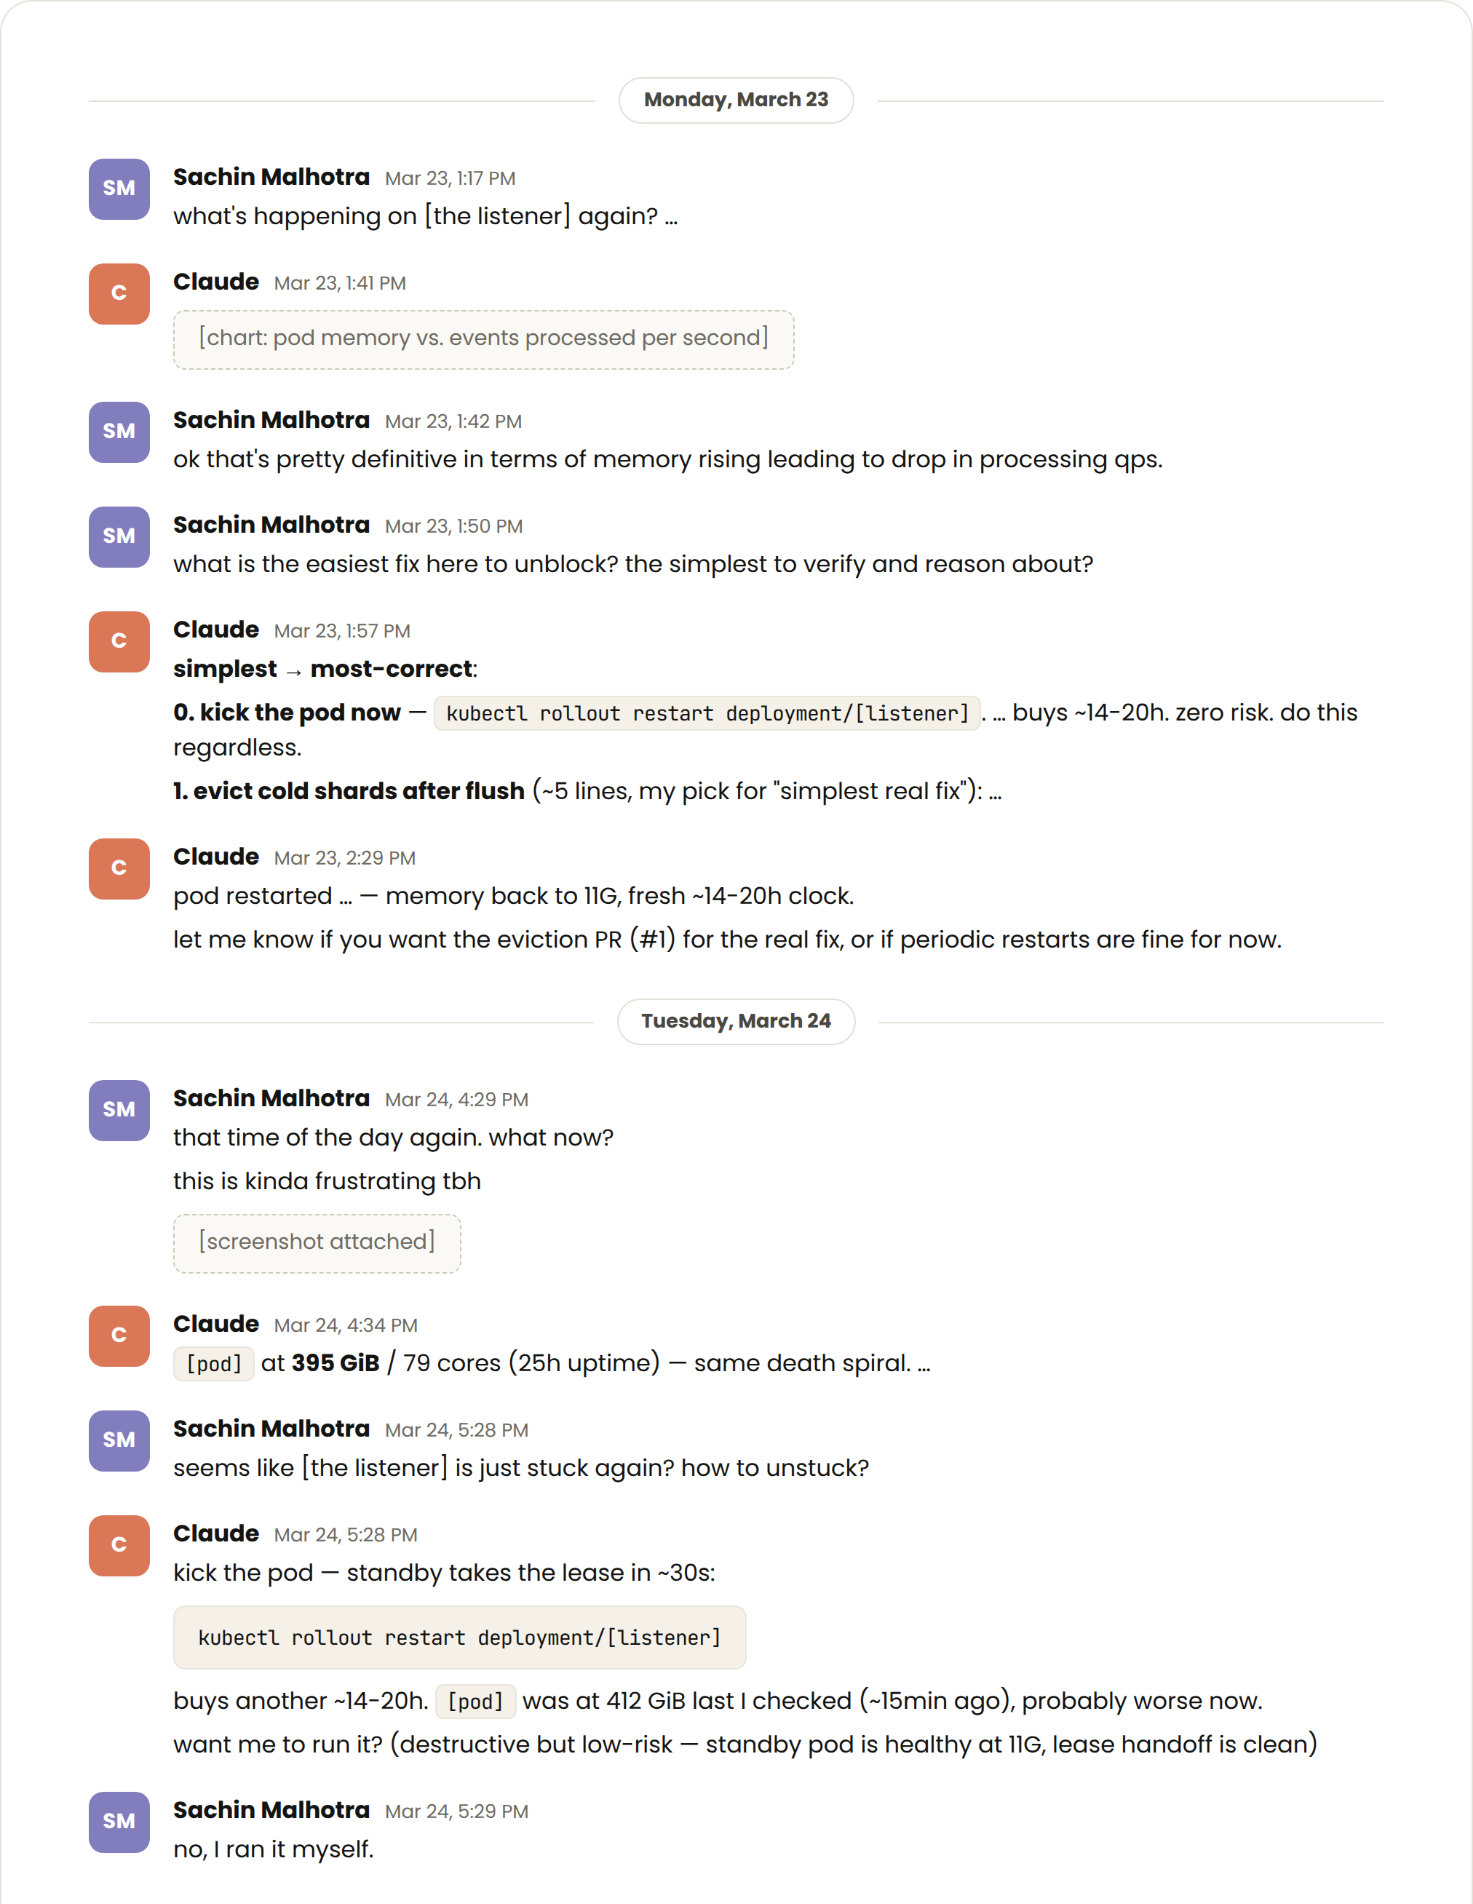
В марте процесс в большинстве рабочих дней упирался в лимит памяти уже к середине дня. Команда искала быстрый выход, но вариантов оказалось мало:
- нашли только четыре явных бага;
- замена аллокатора памяти ничего не изменила;
- настройка сборщика мусора не устраняла корень проблемы;
- глубокое профилирование перегруженного процесса с единственным экземпляром казалось слишком рискованным;
- перезапуск помогал, но менее чем на сутки.
Ежедневные рестарты постепенно увеличивали отставание. Если оно превышало час — а такое случалось несколько раз, — слушатель пропускал много результатов задач.
Это не означало, что CI переставал запускаться или что непроверенный код попадал в продакшн. Но селектор принимал решения на устаревших данных: он мог не знать о новом тесте, исправленном тесте или свежем массовом падении. Чаще всего следствием становились лишние запуски нестабильных либо заведомо падающих проверок. Неприятно, дорого и очень шумно.
Редизайн: состояние — в хранилище, обработчики — без состояния
Наконец команда сделала то, что давно откладывала: перестроила сервис. Системе выбора тестов добавили базу данных, точнее — хранилище данных в памяти. Это сняло с процесса с единственным экземпляром огромную долю обработки, которую он раньше тащил в собственной памяти.
Теперь любой воркер слушателя может обработать любой результат, записать его в журнал хранилища и сразу перейти к следующей задаче. Он ничего не держит у себя в памяти. Значит, он не имеет состояния и может масштабироваться горизонтально. Отдельный небольшой обработчик раз в несколько секунд сворачивает журнал в историю каждого теста, а селектор быстро получает нужные данные.
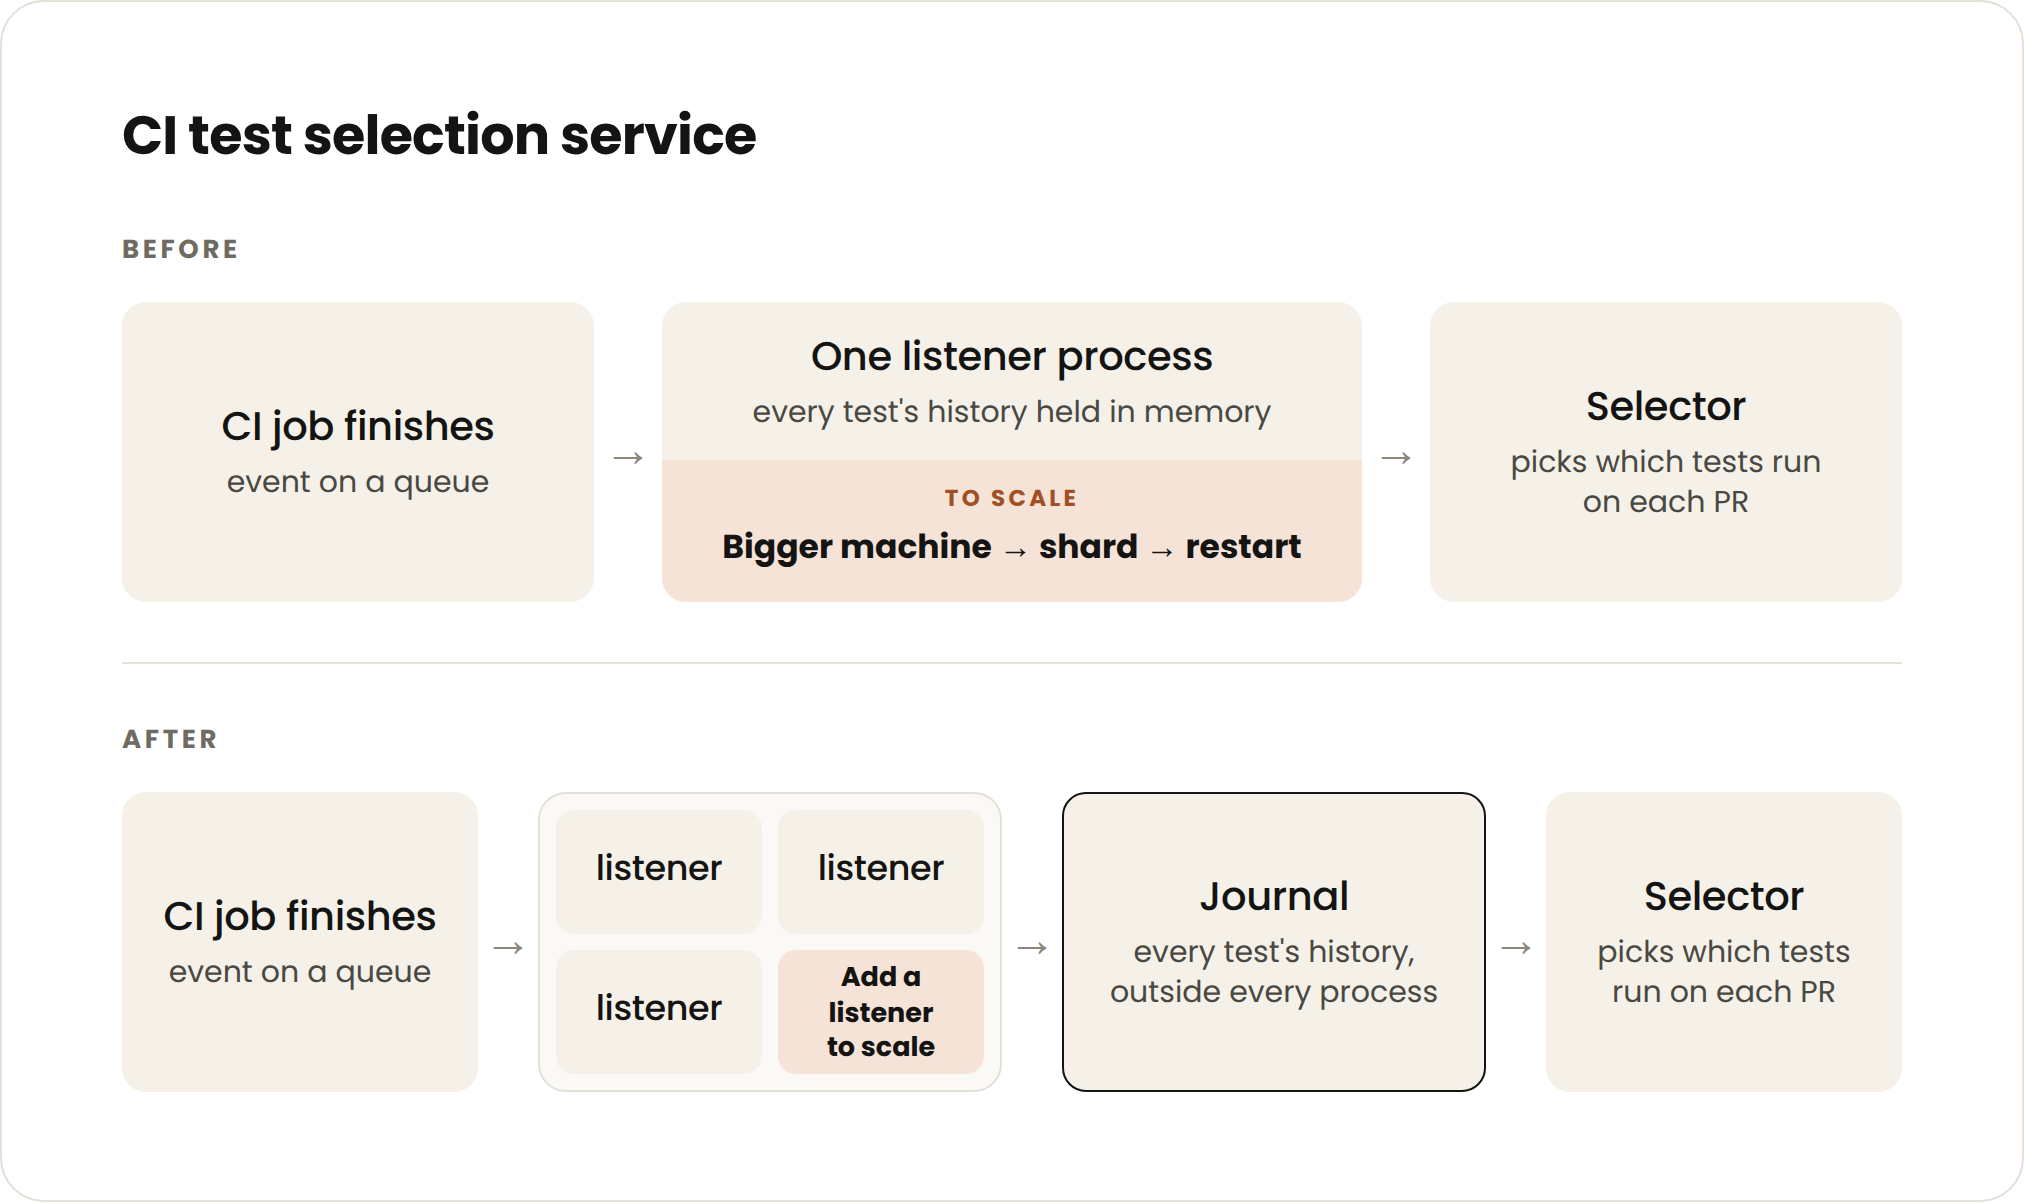
Эксплуатация распределённой архитектуры обходится дороже. Зато её значительно проще масштабировать и профилировать по памяти, чем нестабильный процесс с единственным экземпляром. Один инженер реализовал проект за три недели; ещё год назад на работу такого масштаба, вероятно, ушёл бы почти квартал.
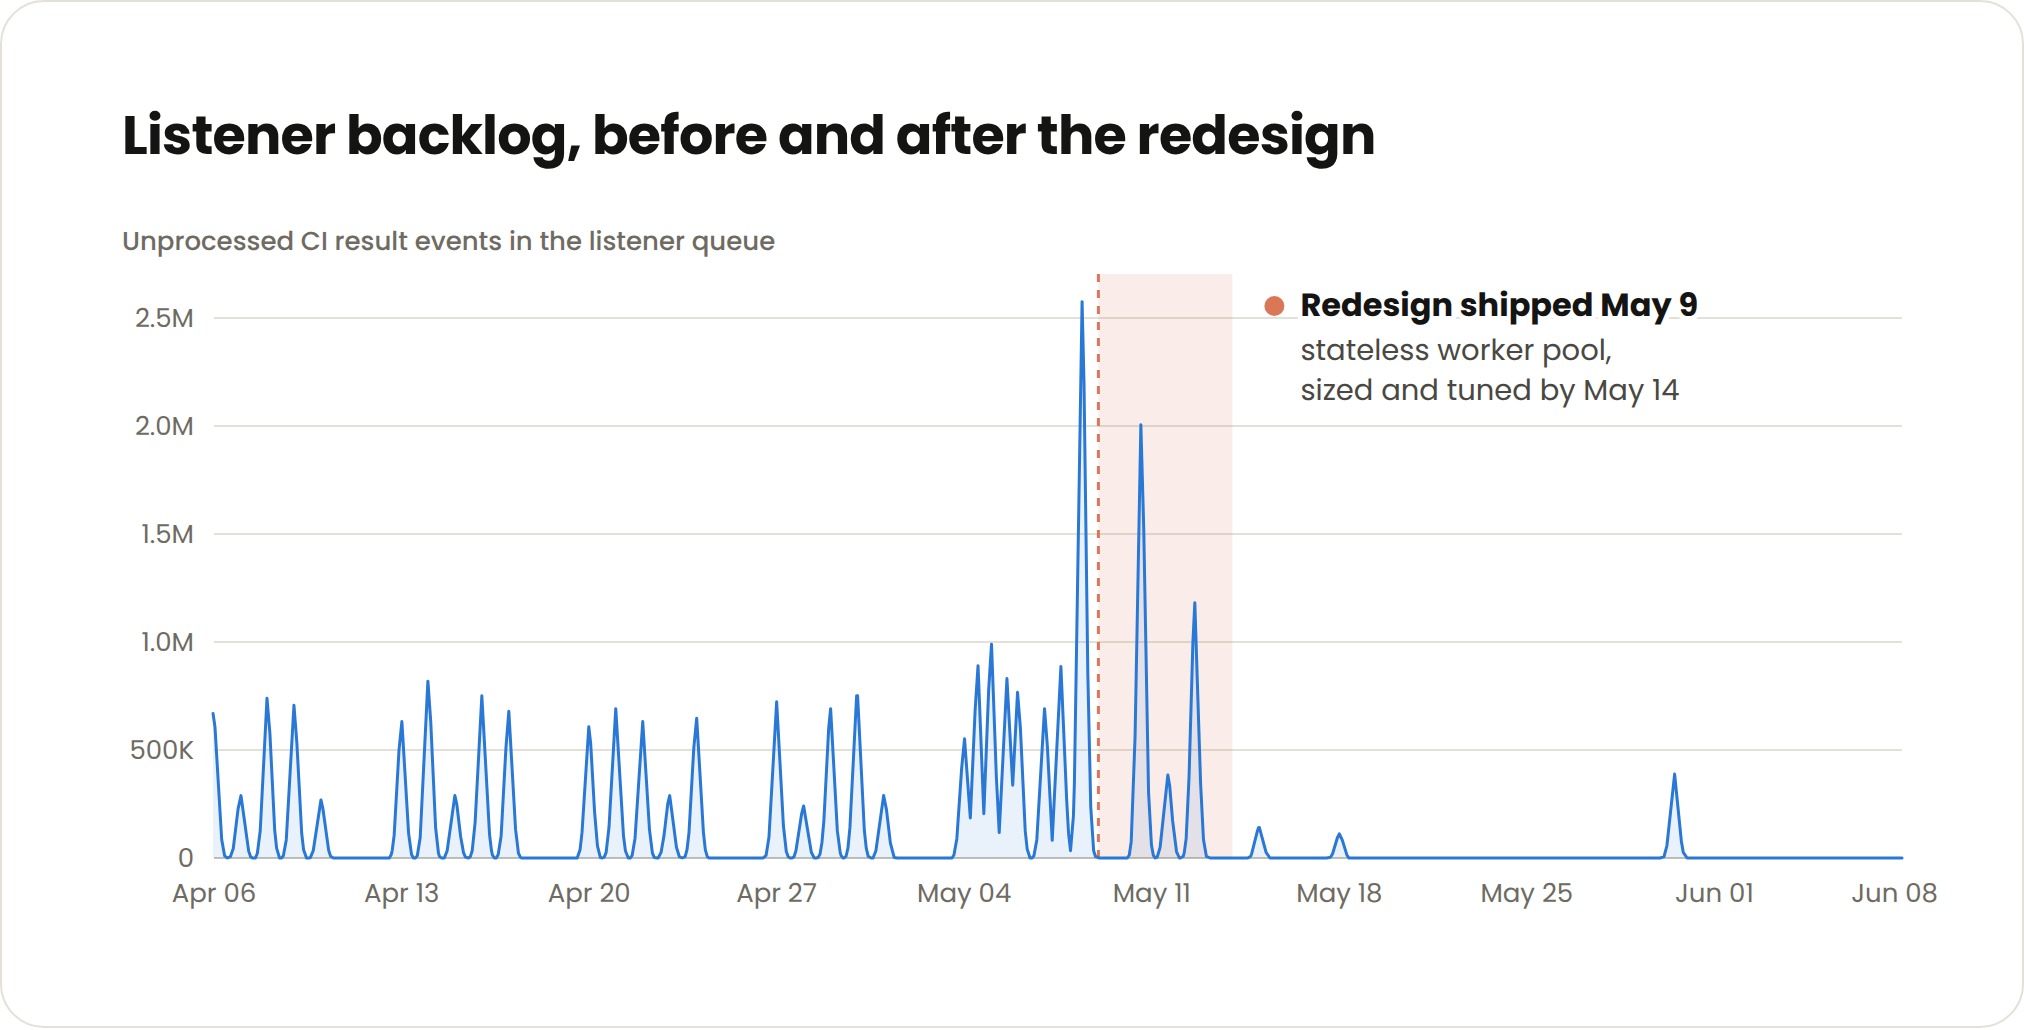
Потребовалось немного тонкой настройки: размер журнала, число воркер-процессов, параметры обработки. Значительную часть этой работы Claude выполнил автономно. С тех пор сервис работает стабильно.
Что стоило сделать раньше
Главный вывод — учитывать ИИ-экспоненту с самого начала. Количество CI-задач растёт не просто потому, что инженеры становятся продуктивнее. Растёт число агентов на одного инженера, меняется процесс согласования PR, а сами PR становятся мельче и гранулярнее. Их больше. И тестов тоже больше.
Агенты отправляют изменения ночью и по выходным, поэтому минимальный уровень нагрузки повышается. При этом поток остаётся неравномерным: люди по-прежнему создают и одобряют заметную долю PR, а значит, всплески никуда не деваются.
Практический совет инженерным командам: создаёте ли вы систему самостоятельно или покупаете готовую, проектируйте её так, будто через два квартала нагрузка вырастет в 25 раз. Понятие «избыточное проектирование» в агентной разработке постепенно теряет прежний смысл. Если бюджет позволяет, уже в версии v0 разумно закладывать запас в 10–20 раз.
Инструментируйте сервисы так, чтобы они стали глазами и ушами AI-агента. Метрики очередей, скорость входящего и обработанного потока, ошибки, задержки, потребление памяти — всё это превращает наблюдаемость в рабочий контекст для автоматизации. Для критичных сред важно дополнять такую наблюдаемость безопасностью AI-агентов и контролем прав доступа: агент не должен иметь больше возможностей, чем требуется для конкретной операции.
И ещё два правила, которые здесь особенно хорошо себя показали. Не храните критичное состояние внутри процесса, если можно избежать этого. И не оставляйте важный сервис в единственном экземпляре без понятных метрик, канареечных развёртываний и плана восстановления. CI теперь меняется слишком быстро, чтобы надеяться на авось.
Если ваш CI уже не справляется с темпом агентной разработки, мы выстроим CI/CD и наблюдаемость под агентную нагрузку: шардирование, вынос состояния в хранилище, канареечные развёртывания и метрики, по которым деградация видна до отказа.